Dominez l’ia de raisonnement : entraînez votre propre modèle type nemotron en 48 heures sur un seul gpu
Comment entraîner un llm avec capacités de raisonnement en 48h avec nvidia nemo
Le futur de l’intelligence artificielle générative ne réside plus seulement dans la prédiction de mots, mais dans la capacité de raisonnement logique (reasoning). Si vous pensiez que créer un modèle comme deepseek-r1 ou nvidia nemotron nécessitait des mois et des millions de dollars, cet article va changer votre vision. Grâce au nvidia nemo framework, il est désormais possible de transformer un modèle standard en expert du raisonnement en un seul week-end.
🚀 Pourquoi le raisonnement (reasoning) change la donne en ia ?
Les modèles de langage classiques répondent instantanément. Les modèles de raisonnement, eux, utilisent le test-time computation. Ils « réfléchissent » avant de répondre, générant une chaîne de pensée (chain-of-thought – cot) interne.
- Performance décuplée : Excellents en mathématiques, code complexe et logique scientifique.
- Contrôle total : Le mode « reasoning on/off » permet d’optimiser les coûts de calcul selon la complexité de la tâche.
🛠️ Configuration technique et prérequis (hardware)
Pour reproduire ce succès sur un seul gpu, voici la configuration cible pour le fine-tuning :
- Gpu performant : Nvidia h100 (80go) ou a100 (80go) avec compute capability >= 8.0.
- Modèle de base : Meta llama 3.1 8b instruct (le point d’équilibre idéal entre taille et performance).
- Stockage : 250 go pour les checkpoints d’entraînement et le dataset.
Ressources essentielles :
- Dataset : llama nemotron post-training dataset (32 millions d’échantillons).
- Outils : nvidia nemo curator pour le nettoyage de données et nemo framework pour le training.
📊 Anatomie du dataset nvidia nemotron
La qualité des données est le moteur de l’alignement ia. Le dataset ouvert par nvidia est une mine d’or pour le post-training :
| domaine | volume d’échantillons | importance seo |
| mathématiques | 22 066 397 | résolution de problèmes complexes |
| programmation (code) | 10 108 883 | génération de code python/c++ |
| sciences | 708 920 | raisonnement scientifique |
| sécurité (safety) | 31 426 | alignement éthique de l’ia |
| total | 32 011 757 | volume massif pour l’open-source |
🏗️ La stratégie d’entraînement en 3 étapes clés
1. Curation de données haute fidélité
La clé n’est pas la quantité, mais la qualité. Utilisez nemo curator pour :
- Filtrer les réponses mathématiques au format latex
\boxed{}. - Éliminer les échantillons vides ou les refus d’assistance.
- Appliquer un curriculum learning : commencez par des exemples simples et augmentez la difficulté (longueur des tokens) progressivement.
2. Fine-tuning avec lora (low-rank adaptation)
Le fine-tuning complet d’un modèle 8b est coûteux. La méthode lora permet d’adapter le modèle avec une efficacité redoutable sur un seul gpu.
Paramètres d’optimisation (hyperparameters) :
- Lora rank : 64 (le « sweet spot » pour le raisonnement).
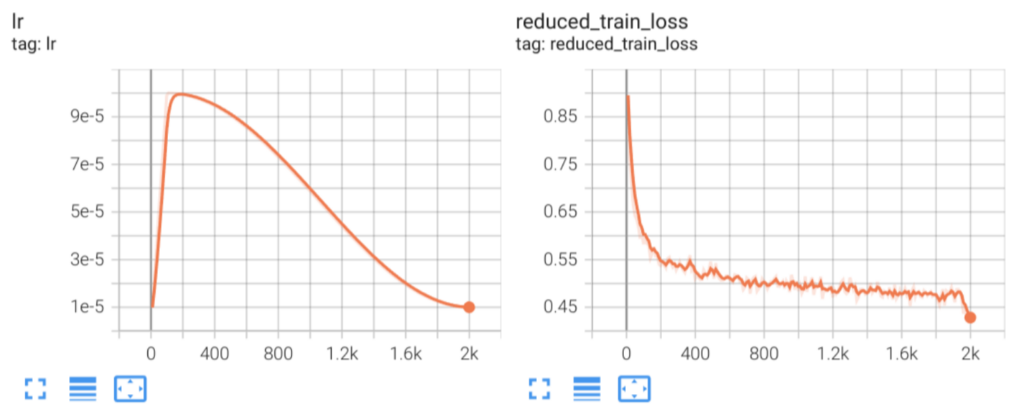
- Learning rate : 0.0001 avec planificateur cosine.
- Batch size : 256 (via accumulation de gradients).
3. Évaluation et benchmarks (gpqa & mmlu)
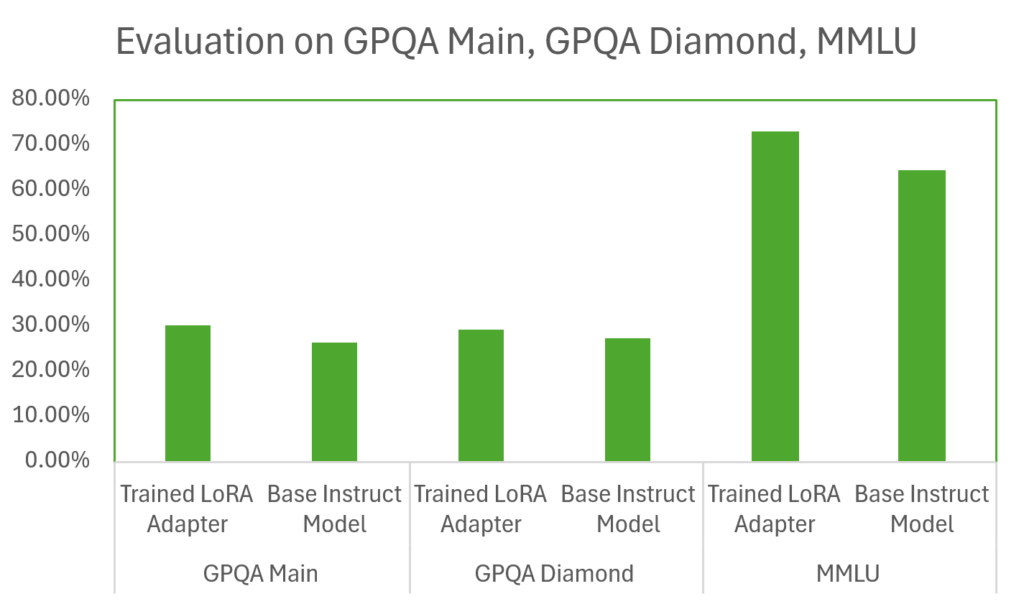
Les résultats sont sans appel : après seulement 30 heures d’entraînement, l’adaptateur lora surpasse le modèle de base de près de 10 points sur les tests de raisonnement complexe comme gpqa diamond.
🎯 Conclusion : créez votre ia souveraine
Le passage au raisonnement n’est plus une barrière technique. En utilisant les outils nvidia nemo et les datasets nemotron, n’importe quel développeur peut spécialiser une ia sur un domaine métier spécifique (finance, droit, ingénierie) en un temps record.
Consultez l’article complet et le tutoriel vidéo ici :